这个数值是否是负值, 概率恒小于1大于0, 取log以后是负数。
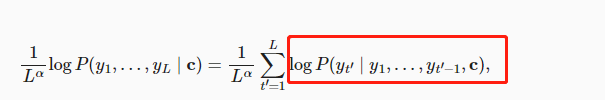
这个数值是否是负值, 概率恒小于1大于0, 取log以后是负数。
是的, 在视频里面有说明:
我觉得束搜索和Viterbi其实都是可以的。
这里没有采用Viterbi的原因主要是每一步可能的选项太多了,使用Viterbi的开销依然很大。
在我的理解里面, Beam Search只是一种选择序列的方法, 并没有需要学习的参数叭?
但是你使用束搜索一样会有这种情况呀,可能还是维比特算法计算量比较大
确实,束搜索也没有解决问题,相比维特比算法,计算量小,效率高。
beam search是在预测的时候使用,而且不需要进行训练;训练的时候有真实的标签并且可以计算损失函数。
谢谢大家的回复,如果我们beam search 的score 函数不是训练来的,如何计算每条路径呢的转移概率呢
可以通过将序列的softmax输出相乘得到转移概率
some questions:
q1: 作者在介绍greedy search时的反例与 beam search的实现策略并非一致,后者只是从root节点分支,分支后各自独立。所以说beam search并不能解决反例
q2: greedy search的反例是多数情况吗?毕竟训练时也是按照概率大的来选择的,而且RNN本身有state context机制,难道‘名师出高徒’可能性不大于‘庸师出高徒’?
明显是漏了exp,与bleu类似的。。。
束搜索那里,为什么说是惩罚长序列?log后面那一坨恒为负数,L越大,整个值不是越大(负得越小)吗?而且根据BLEU的原理来看,类似的话也该是惩罚短序列。
把P放到指数上面能说得通,结合上面提到的b站视频这里应该是漏掉了。
尽管求和 $\sum \log P$ 是负值,最大化这个表达式意味着找到概率 (P\left(\mathbf{y}_{t^\prime} \mid \mathbf{y}1, \cdots, \mathbf{y}{t^\prime-1}, \mathbf{c}\right)) 的乘积最大的序列 (\mathbf{y}),即,找到联合概率最大的序列,经过长度归一化后的得分最高的情况。
我觉得还有一个更重要的原因是:常规的自然语言模型不满足马尔可夫性,所以不满足维比特算法适用的前提。
RNN 实现单步计算满足马尔可夫性,但整体序列建模能力超越马尔可夫性,毕竟,通过隐状态传递了历史信息。
你这个系列笔记整理得挺好,让我眼前一亮。我也不喜欢d2l这个包,本来我打算看完文字和代码的大概意思,练习的时候自己对着AI重新写一遍,不参考原代码。你这相当于是不用d2l那个包,把教程重新写了一遍,版面看着也舒服。
感谢喜欢,我最近在忙别的项目,一直没腾出时间继续学习。但这只是暂停,不是中断
神经网络束搜索比如第一列有k个数据,束大小为b,1<b<k ,按照b个分支进行贪心搜索。那我们可以认为这是纵向的(同一列)。那我们也可以通过横向(不同列)来进行搜索啊。贪心搜索最大的问题就是第n列最大的数据会影响到第n+1列,同时取这两个列的最大概率不一定是全局最大。我们也可以做一个局部的穷举搜索。当我们确定第n列时,第n+1列是确定的,比如我们选k为2,穷举n+1,n+2列的所有可能,选出第n+1列最大的字符,依次向下,这个与贪心搜索不同的就是这个考虑了n+2列,束b越大,局部穷举越大。
这种方法学术届有人研究过吗?
全靠AI,我是傻子
def predict_seq2seq(net, src_sentence, src_vocab, tgt_vocab, num_steps,
                    device, save_attention_weights=False, beam_size=2):
    """序列到序列模型的束搜索预测"""
    net.eval()
    # 源序列预处理
    src_tokens = src_vocab[src_sentence.lower().split(' ')] + [
        src_vocab['<eos>']]
    enc_valid_len = torch.tensor([len(src_tokens)], device=device)
    src_tokens = d2l.truncate_pad(src_tokens, num_steps, src_vocab['<pad>'])
    enc_X = torch.unsqueeze(
        torch.tensor(src_tokens, dtype=torch.long, device=device), dim=0)

    # 编码器前向(源序列编码仅执行一次)
    enc_outputs = net.encoder(enc_X, enc_valid_len)
    dec_state = net.decoder.init_state(enc_outputs, enc_valid_len)

    bos_id = tgt_vocab['<bos>']
    eos_id = tgt_vocab['<eos>']

    # 初始化束候选:(完整序列, 累计对数概率, 解码器隐状态, 注意力权重序列)
    beams = [
        (
            [bos_id],          # 初始序列以 <bos> 开头
            0.0,               # 初始对数概率 log(P=1) = 0
            dec_state,         # 解码器初始隐状态
            []                 # 注意力权重缓存(可选)
        )
    ]
    completed = []  # 已生成 <eos> 的完整序列

    for _ in range(num_steps):
        if not beams:
            break
        candidates = []

        # 逐个扩展当前束中的所有候选
        for seq, log_prob, state, attn_list in beams:
            # 当前步输入:序列最后一个 token,形状 (1, 1)
            dec_X = torch.tensor([[seq[-1]]], dtype=torch.long, device=device)
            # 解码器单步前向
            Y, new_state = net.decoder(dec_X, state)

            # 计算对数概率并取 Top-k 候选(避免遍历全词表,提升效率)
            log_probs = torch.log_softmax(Y.squeeze(0).squeeze(0), dim=-1)
            topk_log_probs, topk_ids = torch.topk(log_probs, beam_size)

            # 扩展出 beam_size 个新候选
            for i in range(beam_size):
                token_id = topk_ids[i].item()
                token_logp = topk_log_probs[i].item()
                new_seq = seq + [token_id]
                new_logp = log_prob + token_logp

                # 缓存注意力权重
                new_attn = attn_list.copy() if save_attention_weights else None
                if save_attention_weights:
                    new_attn.append(net.decoder.attention_weights)

                # 遇到结束符则加入完成列表,不再参与后续扩展
                if token_id == eos_id:
                    completed.append((new_seq, new_logp, new_attn))
                else:
                    candidates.append((new_seq, new_logp, new_state, new_attn))

        # 全局排序,保留概率最高的前 beam_size 个候选进入下一步
        candidates.sort(key=lambda x: x[1], reverse=True)
        beams = candidates[:beam_size]

    # 将未自然结束的候选也加入最终候选池
    for seq, log_prob, state, attn_list in beams:
        completed.append((seq, log_prob, attn_list))

    # 选出全局概率最高的序列
    completed.sort(key=lambda x: x[1], reverse=True)
    best_seq, _, best_attn = completed[0]

    # 去掉开头 <bos> 和结尾 <eos>,转回文本
    output_tokens = best_seq[1:]
    if output_tokens and output_tokens[-1] == eos_id:
        output_tokens = output_tokens[:-1]

    return ' '.join(tgt_vocab.to_tokens(output_tokens)), best_attn